Desenvolvimento Orientado a Modinha (DOM)

Você já trabalhou com equipes que usam aquela metodologia de desenvolvimento infalível, o Desenvolvimento Orientado a Modinha? Você mesmo já usou (e/ou está usando) a mais nova tecnologia de software que aquela grande empresa lançou mês passado? Precisamos conversar sobre Hype Driven Development.
Equipes de desenvolvimento de software muitas vezes tomam decisões sobre arquitetura de software ou pilhas tecnológica com base em opiniões imprecisas, mídias sociais e, em geral, sobre o que é considerado “quente” (hype), em vez de sólida pesquisa e qualquer consideração séria do impacto esperado em seus projetos. Essa tendência pode ser chamada de Desenvolvimento Orientado a Modinha ou DOM — originalmente, Hype Driven Development. Obviamente, existe uma abordagem mais profissional, chamada por alguns de Engenharia de Software Sólido (Solid Software Engineering). Saiba mais sobre como ele funciona e descubra o que você pode fazer em vez disso.
Nova tecnologia, nova esperança
Soa familiar? Uma equipe escolhendo tecnologia mais recente, mais “quente” para aplicar no projeto e alguém lê uma postagem em um blog, vê que é tendência no Twitter e todos acabaram de voltar de uma conferência onde houve uma grande conversa sobre isso. Logo a equipe começa a usar esta nova tecnologia brilhante — ou paradigma de arquitetura de software —, mas em vez de ir mais rápido (como prometido) e construir um produto melhor, começa a se deparar com sérios problemas.
A velocidade de desenvolvimento diminui, todos ficam desmotivados, têm problemas para entregar a próxima versão do projeto para a produção. Algumas equipes ainda mantêm a correção de bugs em vez de fornecer novos recursos. São necessários “apenas mais alguns dias” para resolver tudo…
Desenvolvimento Orientado a Modinha ou Hype Driven Development
O Desenvolvimento Orientado a Modinha (ou Hype Driven Development) vem em muitos sabores e toca seu projeto de muitas maneiras diferentes:
- Desenvolvimento Orientado a Reddit. Quando uma equipe ou indivíduo decide sobre a tecnologia/arquitetura/design com base no blogueiro popular que escreveu o que está quente no Reddit, no Hacker News, no X, no LinkedIn, no GitHub ou em qualquer outra rede.
- Desenvolvimento Orientado a Conferência. Observe cuidadosamente o que acontece depois que pessoas (e programadores) retornam de uma conferência: elas ficam inspiradas. E isso é uma espada de dois gumes: começar a usar o mais novo paradigma/biblioteca/framework/arquitetura sem pesquisa suficiente pode ser uma estrada para o inferno.
- Desenvolvimento Orientado ao Cara que Fala Mais. As decisões mais influentes são as do que está falando o tempo todo sobre esse novo framework/biblioteca/tecnologia que ele não tem experiência, mas fala sobre isso o tempo todo e finalmente a equipe decide adotar a coisa.
- Desenvolvimento Orientado a Gem/lib/plugin. Um viés especialmente forte na comunidade Ruby On Rails, em que é possível ver um Gemfile por tanto tempo que a única coisa que leva mais tempo é para carregar o aplicativo. Vem da idéia de que cada problema em Rails deve ser resolvido através de um gem — sendo que, às vezes, apenas uma ou duas linhas de código dariam conta do recado ao invés de resolver o problema acrescentando mais problemas com libs, plugins, gems e/ou frameworks. Quem nunca viu um Rails com Gemfile quilométrico provavelmente já viu o equivalente em
node_modules: uma dependência de terceiros para formatar data, outra para saber se um número é ímpar. - Desenvolvimento Orientado a Stack Overflow. Certamente uma das mais comuns de acontecer, dá-se quando programadores copiam e colam soluções do Stack Overflow (ou encontradas na web, em geral) sem realmente entendê-las.
A raiz de todo o mal?
O problema com hypes é que eles facilmente levam a más decisões. Tanto a decisões arquitetônicas ruins, quanto a decisões tecnológicas sobre stacks costumam assombrar uma equipe meses ou mesmo anos mais tarde. No pior caso, elas podem levar a outra situação muito problemática em engenharia de software: A Grande Reescrita (The Big Rewrite).
A raiz de todo o mal parece estar nas mídias sociais, nas quais novas idéias se espalham muito mais rápido do que são testadas; muito mais rápido do que as pessoas são capazes de compreender os seus prós e contras.
A anatomia de um hype
A maioria dos hypes têm uma estrutura similar a esta:
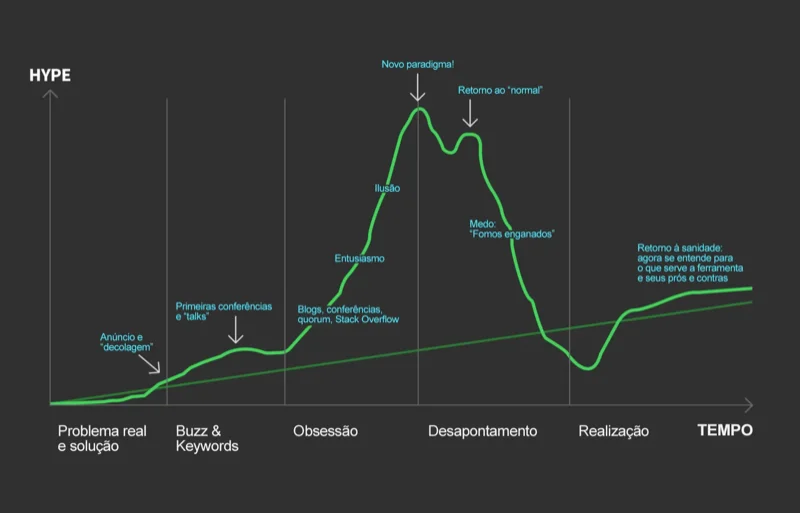
Passo 1: Problema real e solução
Eles começam em alguma empresa com um problema. Uma equipe dentro de alguma empresa decide que a solução para o problema está além da pilha tecnológica atual, processo ou arquitetura. A empresa cria uma nova estrutura, biblioteca ou paradigma e logo o problema é resolvido.
Passo 2: Buzz & Keywords
A equipe está animada para mostrar seu trabalho para o resto do mundo e logo eles escrevem posts e fazem palestras e conferências. O problema muitas vezes não é trivial, então eles se orgulham de apresentar os resultados impressionantes de uma solução “da casa”. As pessoas ficam entusiasmadas com a nova tecnologia. O maior problema é que nem todos que ficam animados são capazes de compreender exatamente qual era o problema inicial e todos os detalhes da solução — afinal, tratava-se de um problema não-trivial com uma solução não-trivial.
Leva mais do que um tweet, bate-papo ou post no blog para explicar. Com ferramentas de comunicação como mídias sociais, artigos de blogs e conferências-relâmpago, ocorre muito ruído na comunicação e a mensagem fica “borrada” ao longo do caminho.
Passo 3: Obsessão
Toda força do hype leva desenvolvedores a lerem artigos e a participarem de conferências sobre a tecnologia. Logo as equipes de todo o mundo começam a usar a usá-la. Devido à mensagem “borrada”, algumas delas tomam decisões precipitadas de uso da tecnologia — mesmo que ela não resolva qualquer um de seus problemas reais. No entanto, a equipe tem expectativa de que esta nova tecnologia vai ajudar.
Passo 4: Desapontamento
Conforme os sprints passam, a tecnologia não melhora a vida da equipe tanto quanto as pessoas esperavam, mas traz muito trabalho extra. Há muita reescrita de código e aprendizagem extra para a equipe. As equipes diminuem a velocidade, a administração fica chateada. Todos se sentem enganados.
Passo 5: Realização
Finalmente, a equipe faz uma retrospecção e percebe quais são os prós e contras da nova tecnologia e para que finalidade ela seria mais relevante. Todos ficam mais sábios… Até o próximo hype aparecer.
Exemplos reais de hypes
É só pensarmos um pouquinho para lembrar de alguns exemplos reais do “Ciclo do Hype”, em ocasiões que trouxeram muitos infortúnios para muitas equipes de desenvolvimento pelo mundo. Alguns seguem doendo; um deles envelheceu bem o suficiente para mudar de lado, e continua na lista justamente por isso.
React
- Problema real e solução. SPAs, como o próprio Facebook, têm tantos eventos de mudança de estado que é difícil manter o controle do que está acontecendo e manter o estado do aplicativo consistente.
- Buzz & Keywords. “Funcional”, “DOM Virtual”, “Componentes”.
- Obsessão. “Facebook criou a estrutura front-end do futuro! Vamos escrever tudo em React de agora em diante!”
- Desapontamento. Não para todo mundo: quem tinha o problema de estado viu o investimento se pagar. A conta chegou para quem reescreveu em React um site institucional de oito páginas e para as equipes que herdaram custo permanente de build, hidratação e atualização de dependência sem nunca ter tido o problema que a biblioteca resolvia.
- Realização. React ganhou o passo que quase nenhum hype ganha: virou infraestrutura. O modelo de componentes venceu tão bem que hoje está em praticamente tudo, inclusive nas ferramentas que não usam React.
Este exemplo entrou na versão de 2017 com outra leitura, e vale mantê-lo justamente porque envelheceu. React é o caso raro em que existe um passo 6, aquele que a conclusão deste texto chama de “a nova melhor prática”.
E ele não desmente o diagnóstico do DOM, refina. O erro de 2016 não foi adotar React: foi adotar React como resposta a uma pergunta que ninguém no projeto tinha feito. A tecnologia se provou, e a Grande Reescrita feita por FOMO continua tendo sido desperdício. Dá para acertar na tecnologia e errar na decisão.
”TDD está morto”
- Problema real e solução. David Heinemeier Hansson (criador do framework Ruby on Rails) percebe que é difícil fazer TDD com Rails — já que ele não tem uma boa arquitetura, que comporta OOP — e faz uma escolha pragmática: não escrever mais testes antecipadamente; não trabalhar mais com TDD.
- Buzz & Keywords. O hype começa com um post no blog de DHH e uma conferência. Termo-chave do hype: “TDD está morto”.
- Obsessão. “Vamos pular os testes! Nosso Guru diz isso. Nós não escrevemos eles de qualquer maneira. Agora, pelo menos, não estamos fingindo. Finalmente somos honestos.”
- Desapontamento. Há muito trabalho, mas nenhum retorno rápido sobre o investimento.
- Realização. “TDD não está morto ou vivo. TDD está sujeito a tradeoffs, incluindo o risco de mudanças de API, habilidades dos participantes e design existente.” — Kent Beck.
Microservices
- Problema real e solução. Grandes aplicações monolítica têm escalonamento difícil. Há um ponto em que é possível dividi-las em serviços. Será mais fácil de escalar em termos de req/sec e mais fácil de escalar entre várias equipes.
- Buzz & Keywords. Palavras-chave do hype: “Escalabilidade”, “Baixo Acoplamento”, “Monolítico”.
- Obsessão. “Temos um ‘código de espaguete’ porque temos uma arquitetura monolítica! Precisamos reescrever tudo para microservices!”
- Desapontamento. Agora é mais lento desenvolver o aplicativo. E difícil de implantar e se passa muito tempo rastreando bugs em vários sistemas.
- Realização. Microservices exigem habilidadess “devops” na equipe. Antes de se chegar a graves questões de escalonamento, são um um investimento excessivo. Microservices são extraídos, não escritos.
NoSQL
- Problema real e solução. Bancos de Dados SQL têm problemas com cargas elevadas e dados não estruturados. Equipes de todo o mundo começam a desenvolver uma nova geração de BDs.
- Buzz & Keywords. Palavras-chave do hype: “Escalabilidade”, “BigData”, “Alta Performance”.
- Obsessão. “Nosso banco de dados é muito lento e não é grande o suficiente! Precisamos do NoSQL!”
- Desapontamento. “Precisamos usar JOIN nas tabelas? Isso é problemático”. Operações SQL simples se tornam cada vez mais desafiadoras. O desenvolvimento fica lento e os principais problemas não são resolvidos.
- Realização. NoSQL são ferramentas para resolver problemas muito específicos — tanto volumes extremamente elevados de dados, dados não estruturados ou cargas muito altas. SQL é realmente uma ótima ferramenta, capaz de lidar com alta carga e volumes de dados enormes se for bem usada.
CSS-in-JS
- Problema real e solução. Num front-end de componentes, CSS global vira campo minado: nome de classe colide, especificidade briga e ninguém tem coragem de apagar uma regra. Escrever o estilo dentro do componente, em JavaScript, resolveu escopo e proximidade de verdade.
- Buzz & Keywords. Palavras-chave do hype: “Escopo”, “Colocation”, “Estilos Dinâmicos”, “o CSS está quebrado”.
- Obsessão. “Nada de arquivo
.cssneste projeto.” Convenções que resolviam boa parte do mesmo problema sem custo de runtime, como BEM e ITCSS, foram descartadas junto, por associação. - Desapontamento. Estilo gerado em tempo de execução se paga em JavaScript: bundle maior, trabalho na thread principal e uma classe nova de dor de cabeça com renderização no servidor e hidratação. Em março de 2025, o styled-components, biblioteca símbolo da abordagem, entrou em modo de manutenção, sem features novas e com o próprio mantenedor dizendo que não o usa mais em produção.
- Realização. O problema era real, e a solução saiu caríssima para quem só precisava de escopo. O ecossistema migrou para geração em tempo de build e para utility-first, enquanto o CSS nativo entregou as peças que faltavam: custom properties,
@layer, nesting e, com a chegada do Firefox 146 em dezembro de 2025,@scopecomo Baseline.
AMP
- Problema real e solução. Em 2015, a web móvel de notícia estava insuportável: página de vários megabytes, meia dúzia de redes de anúncio e o texto pulando de lugar enquanto você tentava ler. O Google lançou o AMP, um subconjunto restrito de HTML com cache próprio, e as páginas realmente carregavam rápido.
- Buzz & Keywords. Palavras-chave do hype: “Instantâneo”, “Mobile-first”, “Top Stories”.
- Obsessão. Não foi só entusiasmo, foi incentivo: por anos, o carrossel de destaque do Google exigia AMP. Redações inteiras passaram a manter duas versões de cada página, e muita gente que não publicava notícia adotou por garantia.
- Desapontamento. Manutenção dobrada, catálogo de componentes limitado, analytics e monetização mais difíceis e URLs que apareciam como se fossem do Google. Boa parte do ganho de velocidade vinha do cache e da restrição, não de algo que o site não pudesse fazer por conta própria.
- Realização. Em julho de 2021, o Google removeu a exigência de AMP para o Top Stories e passou a avaliar experiência de página com Core Web Vitals, que valem para qualquer URL. O AMP continua existindo, sem novidade relevante desde 2023, e boa parte de quem adotou já removeu.
O AMP é o exemplo mais desconfortável da lista, porque nele o passo 3 não foi vaidade de equipe: foi uma plataforma condicionando distribuição. Vale registrar que essa variante existe, e que ela é a única da lista que bom senso, sozinho, não conseguia recusar.
E a lista continua…
O espaço lotado da Engenharia da Computação apresenta muitas áreas em que hypes são comuns. No mundo do JavaScript, por exemplo, novos frameworks são criados todos os dias. Node.js, Programação Reativa, Meteor.js, Front-end MVC, React.js. Na engenharia de software nascem novas arquiteturas: Domain Driven Development, Hexagon, DCI…
Reler essa lista quase dez anos depois já é um exercício por si só. O Node.js virou infraestrutura, o Meteor.js e o “Front-end MVC” praticamente saíram do vocabulário e o Domain Driven Development seguiu vivo num nicho, sem nunca ter virado o padrão que se anunciava. Do lado do front-end, a década ainda rendeu micro-frontends, JAMstack, isomorfismo, SPA para tudo e a volta da renderização no servidor com nome novo.
Nenhum deles era besteira. Todos foram vendidos para muito mais gente do que tinha o problema.
O DOM na era da IA
O artigo original é de 2017. Naquela época, o hype mais caro que uma equipe podia comprar custava algumas semanas de reescrita. Hoje ele vem com contrato de API, orçamento de tokens e a promessa de que a profissão inteira vai mudar até o fim do trimestre.
A anatomia, porém, continua idêntica. Os mesmos 5 passos, só que o ciclo agora roda em meses em vez de anos, porque a distribuição também acelerou: um vídeo, um post e três threads bastam para transformar um experimento de fim de semana em pauta de reunião de diretoria.
Vibe coding
- Problema real e solução. Escrever código à mão para validar uma ideia é caro. Em fevereiro de 2025, Andrej Karpathy descreveu um jeito de trabalhar em que você conversa com o modelo, aceita as sugestões e “esquece que o código existe”. Para protótipo descartável, funciona muito bem.
- Buzz & Keywords. “Vibe coding”, “prompt em vez de sintaxe”, “qualquer pessoa vira dev”. O termo saiu de um tweet e chegou ao New York Times em poucas semanas.
- Obsessão. “Não precisamos mais revisar código. Não precisamos mais contratar júnior. Vamos vibe codar o produto inteiro.”
- Desapontamento. A Moltbook, rede social para agentes de IA lançada em janeiro de 2026, foi construída exatamente assim, e o próprio fundador anunciou que não escreveu uma linha de código. No dia 31 daquele mês, pesquisadores acharam uma chave do Supabase fixada no JavaScript do front-end e nenhuma política de row-level security: cerca de 1,5 milhão de tokens de autenticação de agentes e 35 mil e-mails abertos para quem quisesse ler e escrever.
- Realização. Em fevereiro de 2026, Karpathy escreveu que vibe coding já era passado e passou a defender o que chamou de “agentic engineering”: você não digita o código em 99% do tempo, mas orquestra agentes com especificação, testes, revisão de diff e supervisão.
Repare no detalhe mais cruel desse caso: o passo 5 do autor aconteceu antes do passo 3 de muita gente. Quando um hype é grande o suficiente, o “vamos adotar” de algumas empresas chega depois do “não é bem assim” de quem inventou a coisa.
Agentes de IA
- Problema real e solução. Um LLM sozinho responde, mas não age. Dar a ele ferramentas, memória e um laço de execução resolve tarefas de várias etapas que antes exigiam integração manual.
- Buzz & Keywords. “Autonomia”, “agentic”, “multiagente”, “força de trabalho digital”.
- Obsessão. “Vamos trocar esse fluxo de aprovação por um time de agentes.” No Hype Cycle de 2026 da Gartner, agentic AI aparece no pico das expectativas infladas, enquanto a IA generativa já escorregou para o vale da desilusão. A pesquisa com CIOs mostra o tamanho do salto de fé: 17% das organizações têm agentes em produção e mais de 60% pretendem ter em dois anos, a curva de adoção mais agressiva entre todas as tecnologias medidas.
- Desapontamento. A mesma Gartner projeta que mais de 40% desses projetos serão cancelados até o fim de 2027, por custo, risco pouco claro ou valor de negócio que nunca apareceu.
- Realização. Essa parte ainda está em curso, mas o contorno já dá para ver: agente ganha de fluxo determinístico quando a tarefa é aberta, tolera erro e tem verificação barata. Onde o caminho é conhecido e o erro é caro, um
ifcontinua sendo mais rápido, mais previsível e infinitamente mais fácil de auditar.
Todo problema virou um servidor MCP
- Problema real e solução. Cada integração de ferramenta com LLM exigia um adaptador próprio. O Model Context Protocol padronizou isso e resolveu um incômodo verdadeiro.
- Buzz & Keywords. “Padrão universal”, “o USB-C da IA”.
- Obsessão. Equipes empacotando como servidor MCP coisas que já eram uma chamada HTTP bem documentada.
- Desapontamento. Mais uma camada para manter, mais um processo para subir e uma superfície de segurança nova, com ferramenta maliciosa e prompt injection no pacote.
- Realização. MCP compensa quando você precisa que ferramentas sejam descobertas e reaproveitadas por vários clientes diferentes. Para uma integração única e conhecida, uma função continua bastando.
É o Desenvolvimento Orientado a Gem/lib/plugin do artigo original, com nome novo e um protocolo no meio.
Novos sabores do DOM
Os cinco sabores listados na versão de 2017 continuam todos em atividade, mas alguns ganharam variantes:
- Desenvolvimento Orientado a Changelog. A decisão de arquitetura muda porque saiu um modelo novo na terça. O benchmark subiu três pontos e o roadmap é reescrito na quarta.
- Desenvolvimento Orientado a Thread. A versão atual do Desenvolvimento Orientado a Reddit. Uma thread com demo de 40 segundos, um “isso muda tudo” no primeiro post e nenhuma menção ao que foi cortado para a demo caber em 40 segundos.
- Desenvolvimento Orientado a Chatbot. O sucessor direto do Desenvolvimento Orientado a Stack Overflow, e mais perigoso que ele. Antes você copiava sem entender uma resposta escrita por alguém que talvez entendesse. Agora recebe uma resposta sob medida, com explicação convincente, produzida por algo que não tem como saber se está certo.
- Desenvolvimento Orientado a FOMO Executivo. A diretoria pergunta “qual é a nossa estratégia de IA?” e a resposta precisa caber no próximo slide, não no próximo trimestre.
O que os dados dizem
Em 2017 o artigo original argumentava por bom senso. Hoje, já existe medição, e ela é desconfortável para os dois lados da discussão.
A METR fez um estudo controlado e randomizado com 16 desenvolvedores experientes em 246 tarefas reais, nos repositórios deles mesmos. Antes de começar, eles estimaram que ficariam 24% mais rápidos com as ferramentas de IA. Depois de terminar, acharam que tinham ficado 20% mais rápidos. A medição mostrou que ficaram 19% mais lentos…
O número que interessa aqui não é o 19%. É a distância entre o que foi sentido e o que foi medido, que é justamente o combustível do DOM. E, para não transformar o próprio estudo num hype, dois avisos: a amostra é pequena, as ferramentas eram as de início de 2025 e a própria METR anunciou em 2026 que mudaria o desenho do experimento. Serve como argumento para medir, não como prova de que IA atrasa todo mundo.
A pesquisa com desenvolvedores da Stack Overflow mostra a adoção e o atrito no mesmo gráfico: 84% usam ou pretendem usar ferramentas de IA, mas a maior frustração relatada, com 66%, é lidar com soluções “quase certas, mas não exatamente”, e 45% dizem que depurar código gerado consome mais tempo do que escrever.
No lado corporativo, o relatório The GenAI Divide, do Project NANDA do MIT Media Lab, estimou que 95% dos pilotos de IA generativa nas empresas não produziram impacto mensurável no resultado. O diagnóstico apontado não foi qualidade de modelo: foram ferramentas que nunca entraram no fluxo de trabalho que elas tinham sido compradas para mudar. O relatório não passou por revisão por pares e se apoia em entrevistas e dados autodeclarados, então cabe a mesma ressalva do parágrafo anterior.
O sintoma clássico do Desenvolvimento Orientado à Modinha nunca foi adotar tecnologia nova. É não ter combinado antes como você vai saber se deu certo.
Boas práticas para evitar o DOM
Então, se não podemos confiar no que a internet diz e opiniões de outras pessoas, como tomar decisões inteligentes em relação ao Desenvolvimento Orientado a Modinha? Eis algumas dicas e boas práticas.
Teste e pesquise antes de decidir
Aprenda sobre uma tecnologia não somente de blogs, mas com a experiência. A caráter de testes, invista 1 ou 2 dias para construir um protótipo de alguma funcionalidade na nova tecnologia antes de tomar uma decisão. Deixe a equipe analisar os prós e contras. É possível usar algumas tecnologias competitivas e permitir que diferentes partes da equipe construam protótipos com tecnologias diferentes.
Participar de hackathons é uma ótima maneira de construir a consciência de uma equipe através da análise de tradeoffs de diferentes tecnologias. Tome 1 ou 2 dias para toda a equipe testar todas as tecnologias que estão em ascensão. Isso permitirá que a equipe tome decisões inteligentes por si mesma, com base em sua própria experiência.
Quando arriscar?
A princípio, quando o retorno do investimento é enorme. A maioria das tecnologias são criadas para resolver um problema específico. Você tem esse problema? É um problema grande? Será que vai economizar muito tempo? Será que o uso da tecnologia paga o custo da curva de entrada e reescrita? E se inicialmente retardarmos o desenvolvimento pelo fator de dois? Ou quatro? Ainda vale a pena?
Algumas equipes são mais rápidas do que outras em entregar valor, chegando ao ponto de ficarem entediadas ao realizarem entregas de maneira mais fácil. Essas equipes podem introduzir novas tecnologias com mais freqüência — por outro lado, se a equipe tem problemas com entregas, este um forte indício para proceder com cautela.
Trabalhe com as pessoas certas
Ter uma formação técnica sólida é essencial: pessoas que conhecem diferentes paradigmas, compreendem a teoria da programação (por exemplo, algoritmos, concorrência etc) e têm boa cultura de engenharia tendem a ser menos suscetíveis a hypes.
Experiência também conta muito. Hypes impressionam mais desenvolvedores jovens. Com o passar dos anos, as pessoas que viram muitas tecnologias e estiveram em problemas muitas vezes tendem a ter uma visão mais equilibrada da tecnologia e sabem escolher melhor.
Meça em vez de sentir
Esta é a boa prática que 2017 não tinha como pedir e 2026 exige. O estudo da METR não mostrou que IA é ruim; mostrou que a percepção de ganho e o ganho real podem apontar para lados opostos sem ninguém notar. Vale para qualquer tecnologia nova, mas vale em dobro para ferramentas que dão uma sensação forte de produtividade enquanto você as usa.
Na prática:
- Combine a métrica antes do piloto: tempo de ciclo, retrabalho, bugs que chegam em produção, o que fizer sentido no seu contexto. Se a métrica só aparece depois, ela vai ser escolhida para confirmar a decisão que já foi tomada.
- Mantenha algo comparável fora do experimento. Não precisa ser um estudo controlado; um punhado de tarefas parecidas feitas do jeito antigo já dá base de comparação.
- Dê prazo de validade ao experimento. “Vamos avaliar em seis semanas” é decisão. “Vamos ver no que dá” é adoção.
Não coloque em produção o que você não sabe depurar
O caso da Moltbook não foi falha de modelo, foi falha de fronteira: chave no cliente e nenhuma regra de acesso no banco. Código gerado entra no repositório com o mesmo peso do código escrito, e portanto precisa da mesma revisão, dos mesmos testes e do mesmo cuidado com segredo, autorização e limite de confiança.
Se ninguém na equipe consegue explicar por que aquele trecho funciona, você não tem uma funcionalidade: tem uma dívida com juros que só aparecem no incidente. Sobre isso, escrevemos em A IA gera CSS, mas você sabe se é bom?, que trata do mesmo problema no recorte do front-end.
Conclusão sobre Desenvolvimento Orientado a Modinha
Desenvolvimento Orientado a Modinha (ou Hype Driven Development) não é novidade. Acontece de um hype realmente se consolidar no mercado e se tornar “a nova melhor prática”, mas a quantidade de hypes é tão grande que, estatisticamente, poucos são os que alcançam o status de “paradigma” e se mantêm lá.
As dicas de testar e pesquisar, saber quando arriscar e trabalhar com as pessoas certas — com ênfase aos não tão jovens e/ou aventureiros — realmente surtem resultados. Segui-las pode determinar o sucesso ou fracasso de seus negócios no mundo dos softwares.
Nove anos depois desta publicação, a lista de hypes mudou inteira e o mecanismo continua o mesmo. Isso é até uma boa notícia: quem aprendeu a reconhecer o padrão em 2017, com microservices e NoSQL, reconhece o mesmo padrão em 2026, com agentes e servidores MCP. E a pergunta útil segue sendo aquela de sempre: qual problema meu essa tecnologia resolve, quanto custa descobrir isso e como vou saber se funcionou?
O bom senso sempre foi um dos melhores aliados de todos nós. Parece que é hora de começar a dar mais atenção a este velho amigo.